返回文章

白葱

1 马尔可夫过程#

1.1 从一道高中题开始#

如果你像我一样,没有任何奥赛基础,那么你第一次接触这个名词应该是高中做高考往年题的时候——2019年的全国一卷高考压轴题正是马尔科夫链(Markov Chain),此后各地的一模二模的 Markov 题便如雨后春笋般长了出来。

对于我们今天要讨论的主题,最合适的例子应该是 2024 年武汉二调的填空题压轴:

(武汉市 2024 届高三二月调考 14)“布朗运动”是指微小颗粒永不停息的无规则随机运动。

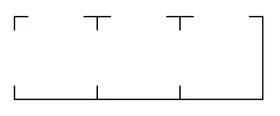
在如图所示的试验容器中,容器由三个仓组成,某粒子作布朗运动时每次会从所在仓的动作口中随机选择一个到达相邻仓或者容器外,一旦粒子到达容器外就会被外部捕获装置所捕获,此时试验结束。已知该粒子初始位置在 1 号仓,则试验结束时该粒子是从 1 号仓到达容器外的概率是?

武汉二调容器示意图

这道题里面一共有四种状态:{1,2,3,out}\{1,2,3,\text{out}\}。状态之间的转移关系可以用有向带权图表示,这里将有向带权图以邻接矩阵表示:

P=[01302313013130120120001]P = \begin{bmatrix} 0 & \frac{1}{3} & 0 & \frac{2}{3} \\[0.2em] \frac{1}{3} & 0 & \frac{1}{3} & \frac{1}{3} \\[0.2em] 0 & \frac{1}{2} & 0 & \frac{1}{2} \\[0.2em] 0 & 0 & 0 & 1 \end{bmatrix}

当前时间步的状态只取决于前一个状态,即:

Pr⁡(Xn+1=j∣Xn=i,Xn−1,…,X0)=Pr⁡(Xn+1=j∣Xn=i)=Pij.\Pr(X_{n+1}=j\mid X_n=i,X_{n-1},\ldots,X_0) =\Pr(X_{n+1}=j\mid X_n=i) =P_{ij}.
定义 1马尔可夫过程

更一般地,对于一个随机过程 {Xt,t∈T}\{X_t, t \in T\},如果对于任意的时间点 tt 和未来的状态 xx,都有:

Pr⁡(Xt+1=x∣Xt=xt,Xt−1=xt−1,…,X0=x0)=Pr⁡(Xt+1=x∣Xt=xt).\Pr(X_{t+1}=x\mid X_t=x_t,X_{t-1}=x_{t-1},\ldots,X_0=x_0) =\Pr(X_{t+1}=x\mid X_t=x_t).

那么我们称该随机过程满足马尔可夫性(Markov Property),是一个马尔可夫过程(Markov Process)。

我们可以用 (S,P)(\mathcal S,P) 定义一个马尔可夫过程,其中 S\mathcal S 是状态空间,PP 是状态转移概率。

1.2 解法一#

老师当时是这样教的:

设运动 nn 次后在 1 号仓的概率为 ana_n,2 号仓为 bnb_n,3 号仓为 cnc_n。 根据状态转移图,我们可以列出:

a0=1,b0=c0=0a_0=1,\qquad b_0=c_0=0 {an=13bn−1bn=13an−1+12cn−1cn=13bn−1\begin{cases} a_n = \frac{1}{3} b_{n-1} \\ b_n = \frac{1}{3} a_{n-1} + \frac{1}{2} c_{n-1} \\ c_n = \frac{1}{3} b_{n-1} \end{cases}

粒子在第 nn 步位于 1 号仓的概率是 ana_n,而在 1 号仓时有 23\tfrac23 的概率下一步就走出容器。

这些事件互不相交,可直接相加:

p1=∑n≥0an⋅23=23∑n≥0anp_1 = \sum_{n \ge 0} a_n \cdot \tfrac23 = \tfrac23 \sum_{n \ge 0} a_n

于是只要求出 A=∑n≥0anA = \sum_{n\ge0} a_n。

记 B=∑bnB = \sum b_n、C=∑cnC = \sum c_n,把三条递推式两边都对 n≥1n \ge 1 求和:

{A−a0=13BB−b0=13A+12CC−c0=13B⟹A=1513, B=613, C=213\begin{cases} A - a_0 = \tfrac13 B \\[2pt] B - b_0 = \tfrac13 A + \tfrac12 C \\[2pt] C - c_0 = \tfrac13 B \end{cases} \quad\Longrightarrow\quad A = \tfrac{15}{13},\ B = \tfrac{6}{13},\ C = \tfrac{2}{13} p1=23⋅1513=1013p_1 = \tfrac23 \cdot \tfrac{15}{13} = \tfrac{10}{13}

1.3 占用测度#

在上面的解题过程中,

A=∑n≥0an=1513>1A = \sum_{n\ge0} a_n = \tfrac{15}{13} > 1
定义 2占用测度

对任意状态 ii,定义轨迹终止前对该状态的访问次数为

Ni=∑n=0τ−11{Xn=i}.N_i=\sum_{n=0}^{\tau-1}\mathbf 1\{X_n=i\}.

从初始分布 ρ\rho 出发时,状态 ii 的占用测度定义为

μρ(i)=Eρ[Ni]=∑n≥0Pr⁡ρ(Xn=i).\mu_\rho(i) =\mathbb E_\rho[N_i] =\sum_{n\ge0}\Pr_\rho(X_n=i).

本题的初始分布集中在 1 号仓,因此

A=μδ1(1),B=μδ1(2),C=μδ1(3).A=\mu_{\delta_1}(1),\qquad B=\mu_{\delta_1}(2),\qquad C=\mu_{\delta_1}(3).

这里我们暂未引入折扣系数,后续会重新在 MDP 过程给出占用测度的完整定义。我们目前只需要建立一个朴素的直觉,占用测度就是随机过程在整个轨迹上的期望访问次数。

2 马尔可夫奖励过程#

2.1 解法二#

接下来我们换一种建模方式,规定粒子从 1 号仓进入容器外时得到 1 分,其余转移得到 0 分,即

r(i,j)=1{i=1,j=out}.r(i,j)=\mathbf 1\{i=1,j=\mathrm{out}\}.

定义期望价值函数 V(i)V(i),即从状态 ii 出发的期望总得分。

由马尔可夫性,从状态 ii 出发,以概率 PijP_{ij} 转移到状态 jj,获得奖励 r(i,j)r(i,j),随后可获得从 jj 出发的未来回报。因此期望价值函数满足关系式:

V(i)=∑jPij[r(i,j)+V(j)],V(out)=0.V(i)=\sum_jP_{ij}\bigl[r(i,j)+V(j)\bigr], \qquad V(\mathrm{out})=0.

即

V(1)=23[1⏟r(1, out)+V(out)]+13[0+V(2)]=23+13V(2)V(2)=13[0⏟r(2, 1)+V(1)]+13[0⏟r(2, 3)+V(3)]+13[0⏟r(2, out)+V(out)]=13V(1)+13V(3)V(3)=12[0⏟r(3, 2)+V(2)]+12[0⏟r(3, out)+V(out)]=12V(2)\begin{align*} V(1) &= \tfrac23\big[\underbrace{1}_{r(1,\,\text{out})} + V(\text{out})\big] + \tfrac13\big[0 + V(2)\big] = \tfrac23 + \tfrac13 V(2) \\ V(2) &= \tfrac13\big[\underbrace{0}_{r(2,\,1)} + V(1)\big] + \tfrac13\big[\underbrace{0}_{r(2,\,3)} + V(3)\big] + \tfrac13\big[\underbrace{0}_{r(2,\,\text{out})} + V(\text{out})\big] = \tfrac13 V(1) + \tfrac13 V(3) \\ V(3) &= \tfrac12\big[\underbrace{0}_{r(3,\,2)} + V(2)\big] + \tfrac12\big[\underbrace{0}_{r(3,\,\text{out})} + V(\text{out})\big] = \tfrac12 V(2) \end{align*}

联立三条方程得:

V(1)=1013,V(2)=413,V(3)=213.V(1)=\tfrac{10}{13},\qquad V(2)=\tfrac{4}{13},\qquad V(3)=\tfrac{2}{13}.

2.2 Bellman 方程#

刚才使用的递推关系

V(i)=∑jPij[r(i,j)+V(j)]V(i)=\sum_jP_{ij}\bigl[r(i,j)+V(j)\bigr]

表示当前状态的价值等于一步奖励与下一状态价值之和的期望。这个递推关系称为Bellman 方程。

定义 3马尔可夫奖励过程

在马尔可夫过程的状态转移上定义奖励,并指定折扣因子 γ\gamma,就得到马尔可夫奖励过程,可以记为

(S,P,r,γ).(\mathcal S,P,r,\gamma).

一般情况下,从第 tt 步开始的折扣回报定义为

Gt=∑k=0∞γkRt+k+1.G_t=\sum_{k=0}^{\infty}\gamma^kR_{t+k+1}.

将第一步奖励从回报中分离出来:

Gt=Rt+1+γGt+1.G_t=R_{t+1}+\gamma G_{t+1}.
定义 4价值函数

价值函数定义为

V(s)=E[Gt∣St=s].V(s)=\mathbb E[G_t\mid S_t=s].

在给定 St=sS_t=s 的条件下,对回报递推式两边取期望:

V(s)=E[Rt+1+γGt+1∣St=s]=∑s′P(s′∣s)[r(s,s′)+γV(s′)].\begin{aligned} V(s) &=\mathbb E\left[R_{t+1}+\gamma G_{t+1}\mid S_t=s\right]\\ &=\sum_{s'}P(s'\mid s) \left[r(s,s')+\gamma V(s')\right]. \end{aligned}

这就是由 (S,P,r,γ)(\mathcal S,P,r,\gamma) 定义的 MRP 的 Bellman 方程。

记状态 sis_i 的单步期望奖励为

rˉ(si)=∑jP(sj∣si)r(si,sj).\bar r(s_i)=\sum_j P(s_j\mid s_i)r(s_i,s_j).

对所有状态分别写出 Bellman 方程,并将结果排列成向量,可以得到

[V(s1)V(s2)⋮V(sn)]⏟V=[rˉ(s1)rˉ(s2)⋮rˉ(sn)]⏟rˉ+γ[P(s1∣s1)P(s2∣s1)⋯P(sn∣s1)P(s1∣s2)P(s2∣s2)⋯P(sn∣s2)⋮⋮⋱⋮P(s1∣sn)P(s2∣sn)⋯P(sn∣sn)]⏟P[V(s1)V(s2)⋮V(sn)]⏟V.\underbrace{ \begin{bmatrix} V(s_1)\\ V(s_2)\\ \vdots\\ V(s_n) \end{bmatrix} }_{\mathbf V} = \underbrace{ \begin{bmatrix} \bar r(s_1)\\ \bar r(s_2)\\ \vdots\\ \bar r(s_n) \end{bmatrix} }_{\bar{\mathbf r}} +\gamma \underbrace{ \begin{bmatrix} P(s_1\mid s_1) & P(s_2\mid s_1) & \cdots & P(s_n\mid s_1)\\ P(s_1\mid s_2) & P(s_2\mid s_2) & \cdots & P(s_n\mid s_2)\\ \vdots & \vdots & \ddots & \vdots\\ P(s_1\mid s_n) & P(s_2\mid s_n) & \cdots & P(s_n\mid s_n) \end{bmatrix} }_{\mathbf P} \underbrace{ \begin{bmatrix} V(s_1)\\ V(s_2)\\ \vdots\\ V(s_n) \end{bmatrix} }_{\mathbf V}.

即

V=rˉ+γPV.\mathbf V=\bar{\mathbf r}+\gamma\mathbf P\mathbf V.

当 0≤γ<10\le\gamma<1 时,I−γPI-\gamma\mathbf P 可逆,因此

V=(I−γP)−1rˉ.\mathbf V=(I-\gamma\mathbf P)^{-1}\bar{\mathbf r}.

2.3 前向占用与后向价值#

答案 1013\tfrac{10}{13} 被我们使用两种方式得出,接下来我们尝试揭示其联系。

对于解法一,我们设的是状态 ii 的单步期望奖励:

rˉ(i)=∑jPijr(i,j).\bar r(i)=\sum_jP_{ij}r(i,j).

在这里,rˉ(1)=23\bar r(1)=\tfrac23,rˉ(2)=rˉ(3)=0\bar r(2)=\bar r(3)=0。

占用测度 μρ(i)\mu_\rho(i) 给出从初始分布 ρ\rho 出发,状态 ii 的期望访问次数。

用每个状态的期望访问次数乘以该状态的单步期望奖励,可以得到总期望回报:

Eρ[G]=∑iμρ(i)rˉ(i).\mathbb E_\rho[G] =\sum_i\mu_\rho(i)\bar r(i).

而对于解法二,价值函数 V(i)V(i) 给出从状态 ii 出发的期望未来回报。用初始分布对各状态价值加权,也可以得到总期望回报:

Eρ[G]=∑iρ(i)V(i).\mathbb E_\rho[G] =\sum_i\rho(i)V(i).

即

1513⋅23+613⋅0+213⋅0⏟按占用测度累计奖励=1⋅V(1)+0⋅V(2)+0⋅V(3)⏟按初始分布计算价值=1013.\underbrace{ \frac{15}{13}\cdot\frac23+ \frac6{13}\cdot0+ \frac2{13}\cdot0 }_{\text{按占用测度累计奖励}} = \underbrace{ 1\cdot V(1)+0\cdot V(2)+0\cdot V(3) }_{\text{按初始分布计算价值}} = \frac{10}{13}.

3 马尔可夫决策过程#

3.1 定义 MDP#

在前面的马尔可夫奖励过程中,粒子的转移规则已经由矩阵 PP 确定。给定当前状态后,我们只能计算未来回报,无法选择接下来的转移方式。

定义 5马尔可夫决策过程

为此,我们在马尔可夫奖励过程中加入动作集合,并允许转移概率与奖励依赖动作,就得到马尔可夫决策过程(Markov Decision Process, MDP):

(S,A,P,r,γ).(\mathcal S,\mathcal A,P,r,\gamma).

其中

S:状态空间,A:动作空间,P(s′∣s,a):状态转移概率,r(s,a,s′):执行动作并发生转移时的奖励,γ:折扣因子.\begin{aligned} \mathcal S &: \text{状态空间},\\ \mathcal A &: \text{动作空间},\\ P(s'\mid s,a) &: \text{状态转移概率},\\ r(s,a,s') &: \text{执行动作并发生转移时的奖励},\\ \gamma &: \text{折扣因子}. \end{aligned}

3.2 策略#

定义 6策略

在 MDP 中,策略是从状态到动作分布的映射:

π:S×A→[0,1],π(a∣s)=Pr⁡(At=a∣St=s).\pi: \mathcal S \times \mathcal A \to [0,1], \qquad \pi(a\mid s)=\Pr(A_t=a\mid S_t=s).

满足对每个 ss 有 ∑a∈Aπ(a∣s)=1\sum_{a\in\mathcal A}\pi(a\mid s)=1。

3.3 策略诱导的 MRP#

策略 π\pi 一旦固定,状态 ss 下各个动作的选择概率也随之确定。将动作变量求和,可以得到策略 π\pi 下的状态转移概率:

Pπ(s′∣s)=∑aπ(a∣s)P(s′∣s,a).P^\pi(s'\mid s) =\sum_a\pi(a\mid s)P(s'\mid s,a).

相应的单步期望奖励为

rˉπ(s)=∑aπ(a∣s)∑s′P(s′∣s,a)r(s,a,s′).\bar r^\pi(s) =\sum_a\pi(a\mid s) \sum_{s'}P(s'\mid s,a)r(s,a,s').

因此,每个策略都会在同一个 MDP 上诱导(induce)出一个 MRP。前面得到的 MRP Bellman 方程可以直接写成

Vπ=rˉ π+γPπVπ.\mathbf V^\pi =\bar{\mathbf r}^{\,\pi} +\gamma\mathbf P^\pi\mathbf V^\pi.

将矩阵方程按状态展开:

Vπ(s)=∑aπ(a∣s)∑s′P(s′∣s,a)[r(s,a,s′)+γVπ(s′)].V^\pi(s) =\sum_a\pi(a\mid s) \sum_{s'}P(s'\mid s,a) \left[r(s,a,s')+\gamma V^\pi(s')\right].

这个方程在给定策略 π\pi 后计算各个状态的价值,称为 Bellman 期望方程。

3.4 状态价值与动作价值#

定义 7状态价值与动作价值

给定策略 π\pi,状态价值函数定义为

Vπ(s)=Eπ[Gt∣St=s].V^\pi(s) =\mathbb E_\pi[G_t\mid S_t=s].

它表示当前位于状态 ss,随后按照策略 π\pi 选择动作时的期望回报。动作价值函数定义为

Qπ(s,a)=Eπ[Gt∣St=s,At=a].Q^\pi(s,a) =\mathbb E_\pi[G_t\mid S_t=s,A_t=a].

它表示当前位于状态 ss,先执行动作 aa,随后按照策略 π\pi 行动时的期望回报。对于前面的容器问题,Vπ(s)V^\pi(s) 对应粒子位于仓 ss、尚未选择动作时的价值,Qπ(s,a)Q^\pi(s,a) 对应粒子已经决定选择动作 aa 时的价值。

在状态 ss 下,策略以概率 π(a∣s)\pi(a\mid s) 选择动作,因此

Vπ(s)=∑aπ(a∣s)Qπ(s,a)(A)V^\pi(s) =\sum_a\pi(a\mid s)Q^\pi(s,a) \tag{A}

当前动作 aa 给定后,环境以概率 P(s′∣s,a)P(s'\mid s,a) 转移到下一状态,因此

Qπ(s,a)=∑s′P(s′∣s,a)[r(s,a,s′)+γVπ(s′)](B)Q^\pi(s,a) =\sum_{s'}P(s'\mid s,a) \left[r(s,a,s')+\gamma V^\pi(s')\right] \tag{B}

式 (A)(A) 对策略选择的动作求期望,式 (B)(B) 对环境产生的下一状态求期望。将式 (A)(A) 代入式 (B)(B),还可以得到只包含动作价值的 Bellman 期望方程:

Qπ(s,a)=∑s′P(s′∣s,a)[r(s,a,s′)+γ∑a′π(a′∣s′)Qπ(s′,a′)].Q^\pi(s,a) =\sum_{s'}P(s'\mid s,a) \left[ r(s,a,s') +\gamma\sum_{a'}\pi(a'\mid s')Q^\pi(s',a') \right].

3.5 Bellman 最优方程#

定义 8最优价值函数

Bellman 期望方程用于计算给定策略的价值。为了比较所有策略,定义最优状态价值函数和最优动作价值函数:

V∗(s)=max⁡πVπ(s),Q∗(s,a)=max⁡πQπ(s,a).V^*(s)=\max_\pi V^\pi(s), \qquad Q^*(s,a)=\max_\pi Q^\pi(s,a).

在状态 ss 下,选择使当前奖励与后续最优价值之和最大的动作,可以得到

V∗(s)=max⁡a∑s′P(s′∣s,a)[r(s,a,s′)+γV∗(s′)].V^*(s) =\max_a \sum_{s'}P(s'\mid s,a) \left[r(s,a,s')+\gamma V^*(s')\right].

这就是状态价值函数的 Bellman 最优方程。对于动作价值函数,当前动作 aa 已经给定,动作选择发生在到达下一状态以后:

Q∗(s,a)=∑s′P(s′∣s,a)[r(s,a,s′)+γmax⁡a′Q∗(s′,a′)].Q^*(s,a) =\sum_{s'}P(s'\mid s,a) \left[ r(s,a,s') +\gamma\max_{a'}Q^*(s',a') \right].

两种最优价值之间满足

V∗(s)=max⁡aQ∗(s,a).V^*(s)=\max_a Q^*(s,a).

得到 Q∗Q^* 后,可以在每个状态选择动作价值最大的动作:

π∗(s)∈arg⁡max⁡aQ∗(s,a).\pi^*(s)\in\arg\max_a Q^*(s,a).

固定策略会诱导出一个 MRP,其价值满足 Bellman 期望方程;在可选动作中逐状态取最大值,则得到 Bellman 最优方程。
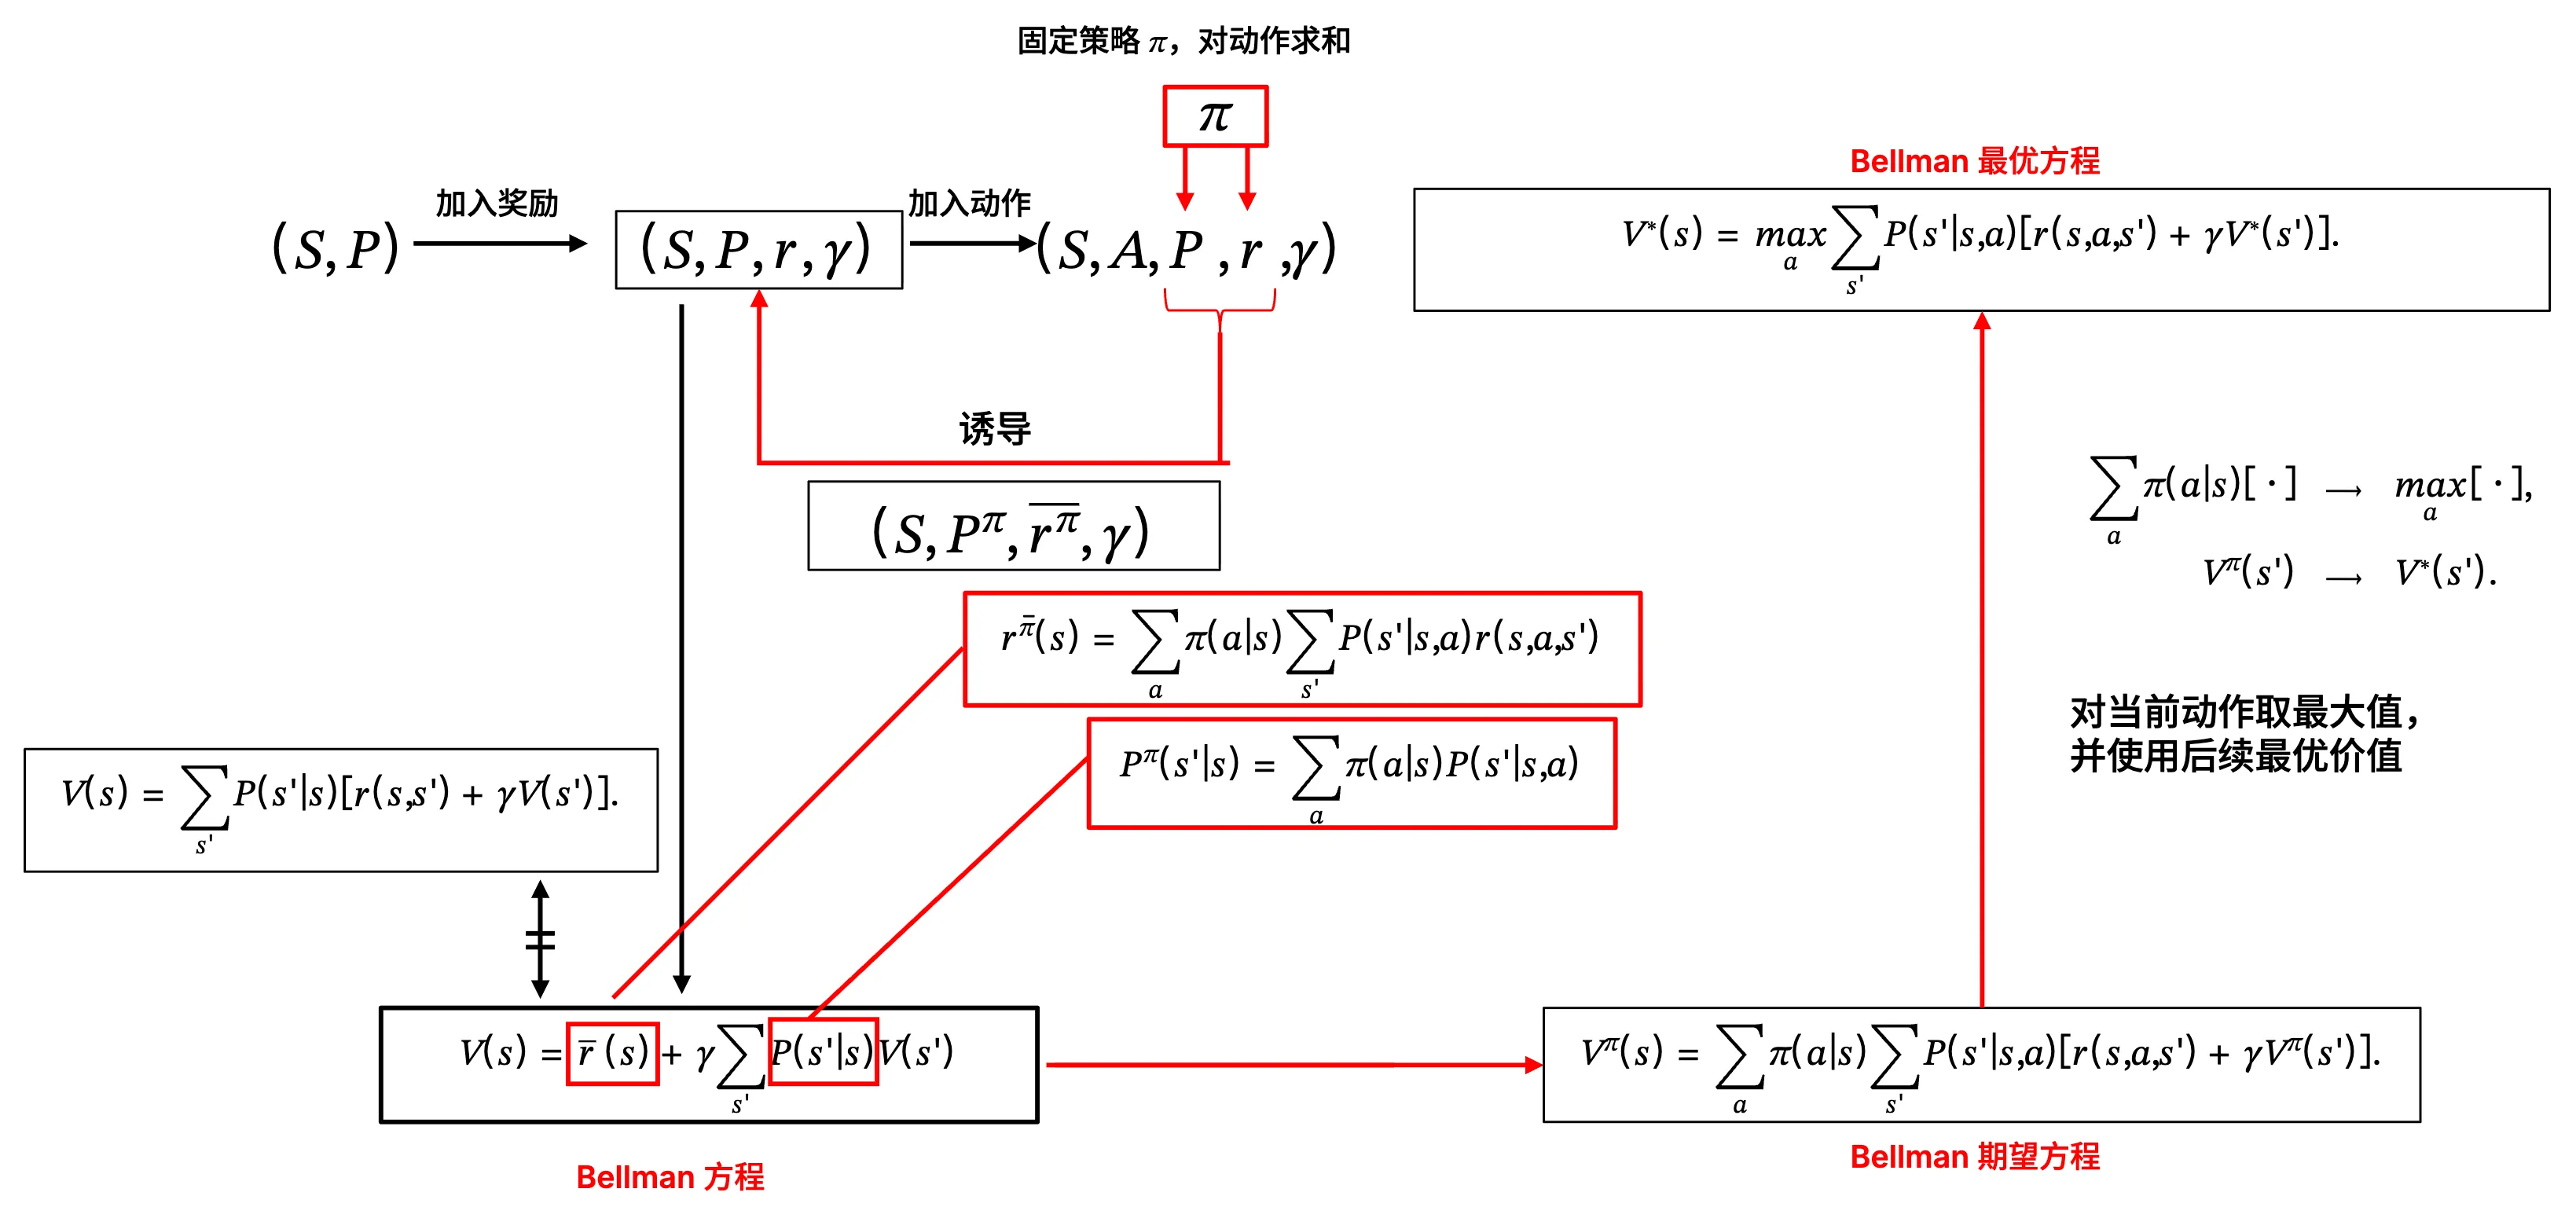
马尔可夫过程、马尔可夫奖励过程与马尔可夫决策过程中的 Bellman 方程关系

引用本文

Candlest. 从高中数学到 MDP[EB/OL]. (2026-08-22). https://blog.candlest.cc/archives/1027.

BibTeX
@online{candlest2026,
  author = {Candlest},
  title = {从高中数学到 MDP},
  date = {2026-08-22},
  url = {https://blog.candlest.cc/archives/1027}
}