
Lec 1#
为什么要学这门课#
我们越来越和底层技术脱节了:
- 最开始的 ML 研究者会手写 CUDA,能掌控自己写的每一层神经网络。
- BRET 时代后人们开始微调。
- LLM 时代,我们只需要写 Prompt。在 2026 年,我们已经可以许愿式编程了。
LLM 的 Stack 实际上很小,我们有必要了解全流程,构建出新的东西。
LLM 的集权#
训练 LLM 所需成本越来越大,前沿技术掌握在少数企业手中。
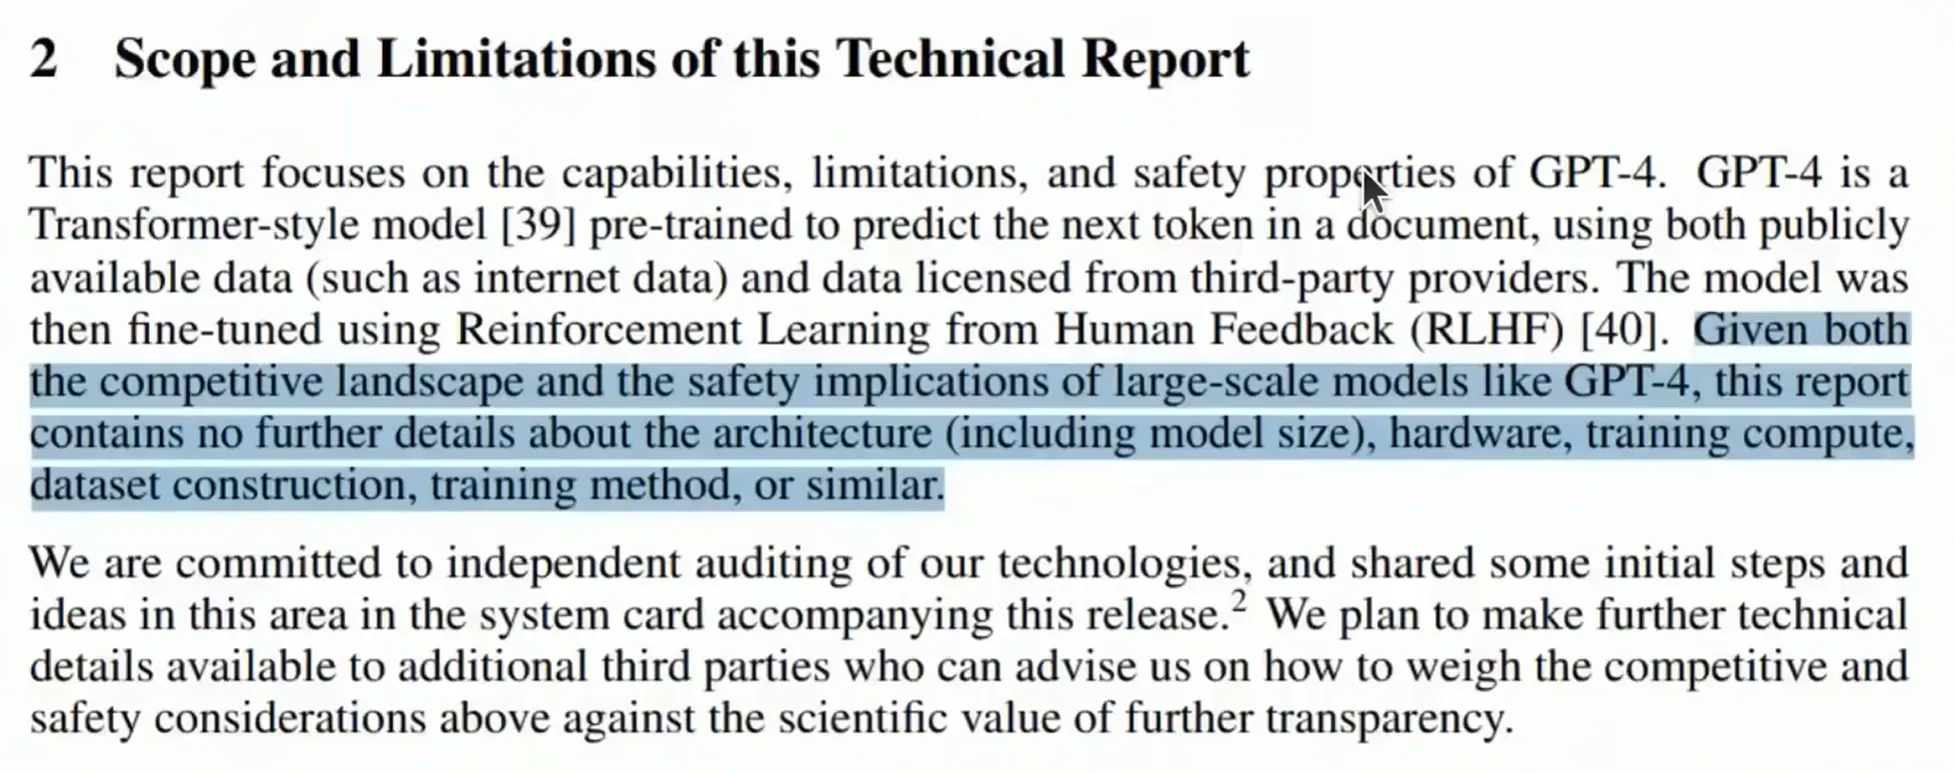
我们需要注意到,小参数的情况可能无法迁移到大参数上。
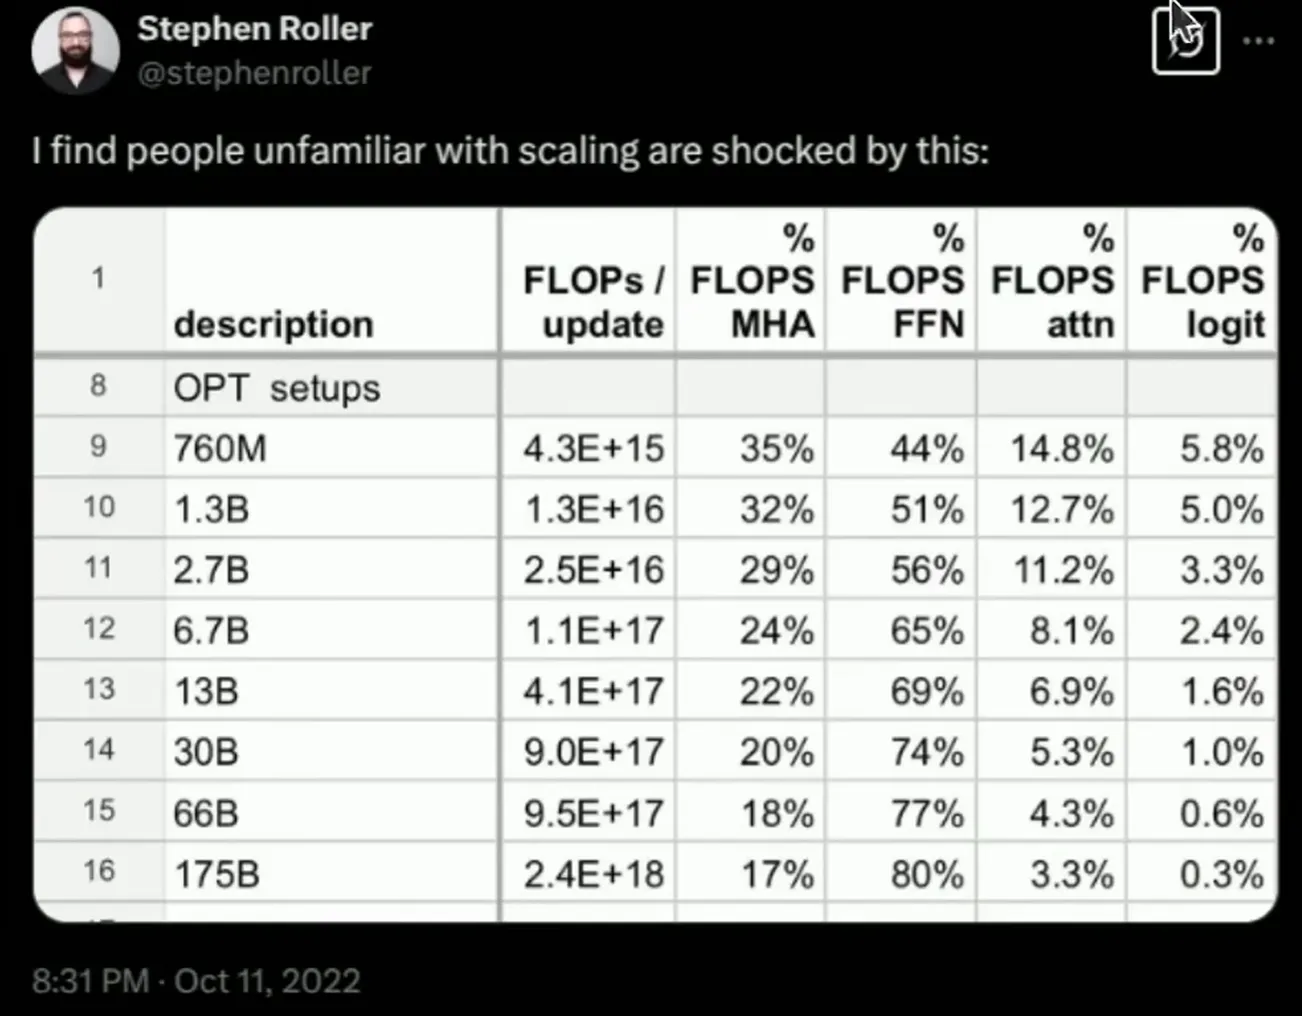
面对算力 Gap 的我们#
尽管规模变得非常庞大,但是我们依然在 GPU 上使用 kernel 和并行进行构建,并且使用梯度进行优化。
可以学到直觉(小的)、思维方式(并行、kernel)和运行方式。
屠龙之技。
熟记 the bitter lesson,最大化效率。
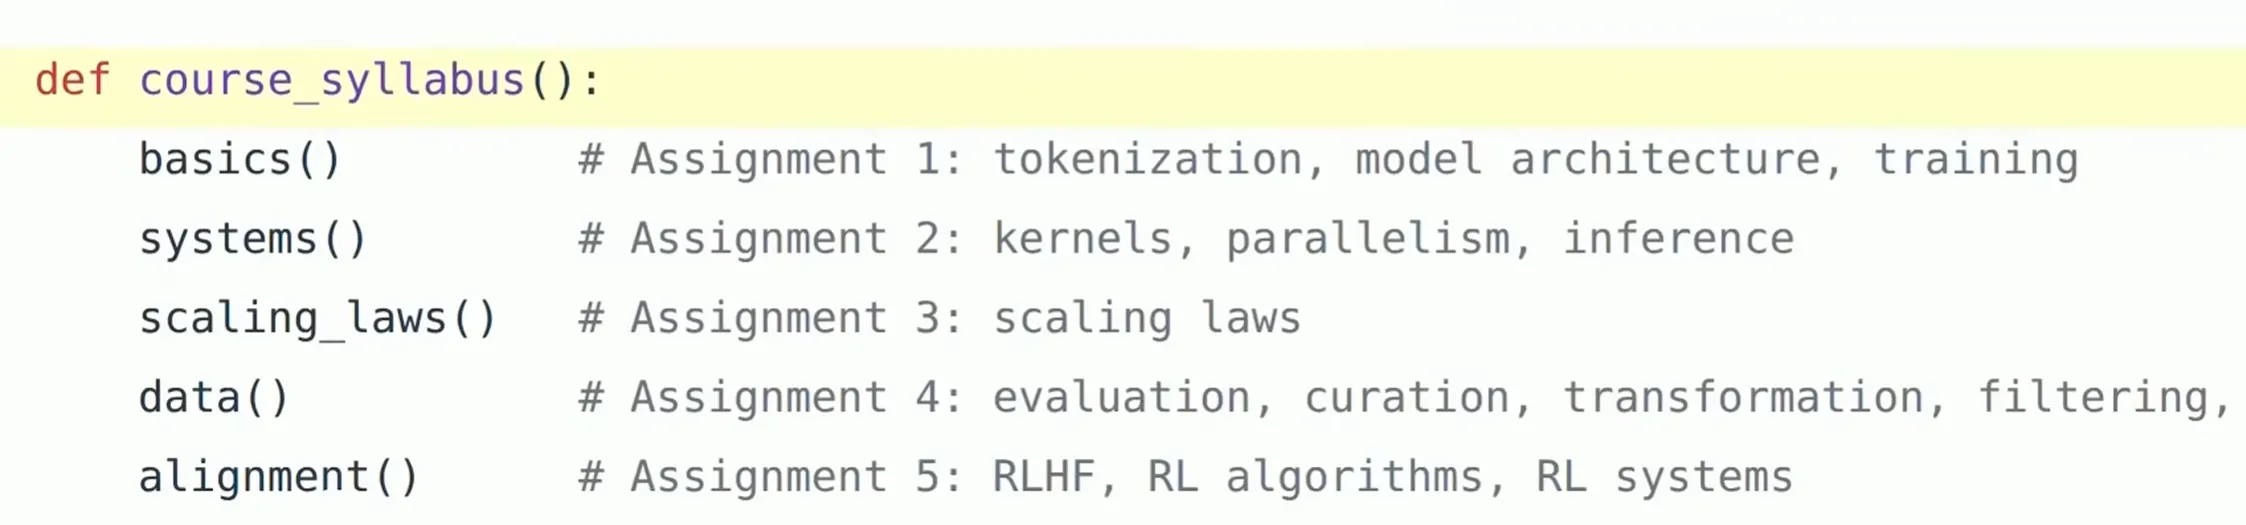
五次作业#
分词器#
有一些尝试使用字节代替 token 的工作比如 H-Net 但是目前还是以分词器为主。
注意力是平方复杂度,我们需要更短的序列,就是更高的压缩比。但是往往会受到表达效果的权衡。、
BPE Tokenizer#
首先,把文本变成字节序列。 然后,统计最常见的组合,把它作为一个整体放入词表。 接着,用词表里的新 token 来表示这一对最常出现的组合。 最后,进一步迭代。
其实这还是一个 encoder,让零碎的东西变得可建模。
Kernel(算子)#
PyTorch 调用内置算子在 GPU 上运行,但是实际上在特定硬件上对特定计算做优化永远是有空间的。
现代计算机是存算分离的,我们必须尽量减少搬运。
多 GPU 并行#
假如我们有千卡集群,我们要在不同的主机的不同的 GPU 之间搬运:
- 模型权重
- 激活值
- 梯度
- 优化器状态
切分的方式和取舍。
推理 inference#
不管是 rollout 还是 test time scaling 还是合成数据,都非常重要。
prefill and decode。
Lec 2 资源核算#
Q1: 在 1024 张 H100 上训一个 70B 参数、15T tokens 的模型要多久?
A1: 经验公式是:训练每个 token 约需 6N FLOPs,前向 2B,反向4B。
而查表取 H100 的 1979 TFLOPS(FP8 峰值)除以 2 记作 990 TFLOPs/卡
折损系数 mfu = 0.5,因为有一半的时间是在搬数据,以及各种其他损耗。
Q2:不考虑任何优化技巧(naive),8 张 H100 用 AdamW 最多能训多大的模型?
A2: 权重,梯度和优化器状态需要被放到 640 G 显存中。
对于每个权重:
- bf16 储存权重和梯度,共 4B
- fp32 储存优化器一阶矩和二阶矩,8B
则可训练参数:
如果换成 Muom 优化器,每个参数只需要储存一份动量 fp32,也就是说有 1/3 的显存被空了出来。
我们可以训练约 80B 的模型。
MFU#
指导我们怎么优化
先算出逻辑上应该执行的flop数,再看实际 wall clock 时间,根据你的显卡算力做比。0.5 是一个正常的值。 使用被硬件优化过的精度,比如在 H100 上,BF16 要远快于 FP32。
内存受限和计算受限(屋顶线模型)#
计组讲过了。