1 马尔可夫过程#
1.1 从一道高中题开始#
如果你像我一样,没有任何奥赛基础,那么你第一次接触这个名词应该是高中做高考往年题的时候——2019年的全国一卷高考压轴题正是马尔科夫链(Markov Chain),此后各地的一模二模的 Markov 题便如雨后春笋般长了出来。
对于我们今天要讨论的主题,最合适的例子应该是 2024 年武汉二调的填空题压轴:
(武汉市 2024 届高三二月调考 14)“布朗运动”是指微小颗粒永不停息的无规则随机运动。
在如图所示的试验容器中,容器由三个仓组成,某粒子作布朗运动时每次会从所在仓的动作口中随机选择一个到达相邻仓或者容器外,一旦粒子到达容器外就会被外部捕获装置所捕获,此时试验结束。已知该粒子初始位置在 1 号仓,则试验结束时该粒子是从 1 号仓到达容器外的概率是?
这道题里面一共有四种状态:{1,2,3,out}。状态之间的转移关系可以用有向带权图表示,这里将有向带权图以邻接矩阵表示:
P=03100310210031003231211
当前时间步的状态只取决于前一个状态,即:
Pr(Xn+1=j∣Xn=i,Xn−1,…,X0)=Pr(Xn+1=j∣Xn=i)=Pij.
定义 1马尔可夫过程
更一般地,对于一个随机过程 {Xt,t∈T},如果对于任意的时间点 t 和未来的状态 x,都有:
Pr(Xt+1=x∣Xt=xt,Xt−1=xt−1,…,X0=x0)=Pr(Xt+1=x∣Xt=xt).那么我们称该随机过程满足马尔可夫性(Markov Property),是一个马尔可夫过程(Markov Process)。
我们可以用 (S,P) 定义一个马尔可夫过程,其中 S 是状态空间,P 是状态转移概率。
1.2 解法一#
老师当时是这样教的:
设运动 n 次后在 1 号仓的概率为 an,2 号仓为 bn,3 号仓为 cn。
根据状态转移图,我们可以列出:
a0=1,b0=c0=0
⎩⎨⎧an=31bn−1bn=31an−1+21cn−1cn=31bn−1
粒子在第 n 步位于 1 号仓的概率是 an,而在 1 号仓时有 32 的概率下一步就走出容器。
这些事件互不相交,可直接相加:
p1=n≥0∑an⋅32=32n≥0∑an
于是只要求出 A=∑n≥0an。
记 B=∑bn、C=∑cn,把三条递推式两边都对 n≥1 求和:
⎩⎨⎧A−a0=31BB−b0=31A+21CC−c0=31B⟹A=1315, B=136, C=132
p1=32⋅1315=1310
1.3 占用测度#
在上面的解题过程中,
A=n≥0∑an=1315>1
定义 2占用测度
对任意状态 i,定义轨迹终止前对该状态的访问次数为
Ni=n=0∑τ−11{Xn=i}.从初始分布 ρ 出发时,状态 i 的占用测度定义为
μρ(i)=Eρ[Ni]=n≥0∑ρPr(Xn=i).
本题的初始分布集中在 1 号仓,因此
A=μδ1(1),B=μδ1(2),C=μδ1(3).
这里我们暂未引入折扣系数,后续会重新在 MDP 过程给出占用测度的完整定义。我们目前只需要建立一个朴素的直觉,占用测度就是随机过程在整个轨迹上的期望访问次数。
2 马尔可夫奖励过程#
2.1 解法二#
接下来我们换一种建模方式,规定粒子从 1 号仓进入容器外时得到 1 分,其余转移得到 0 分,即
r(i,j)=1{i=1,j=out}.
定义期望价值函数 V(i),即从状态 i 出发的期望总得分。
由马尔可夫性,从状态 i 出发,以概率 Pij 转移到状态 j,获得奖励 r(i,j),随后可获得从 j 出发的未来回报。因此期望价值函数满足关系式:
V(i)=j∑Pij[r(i,j)+V(j)],V(out)=0.
即
V(1)V(2)V(3)=32[r(1,out)1+V(out)]+31[0+V(2)]=32+31V(2)=31[r(2,1)0+V(1)]+31[r(2,3)0+V(3)]+31[r(2,out)0+V(out)]=31V(1)+31V(3)=21[r(3,2)0+V(2)]+21[r(3,out)0+V(out)]=21V(2)
联立三条方程得:
V(1)=1310,V(2)=134,V(3)=132.
2.2 Bellman 方程#
刚才使用的递推关系
V(i)=j∑Pij[r(i,j)+V(j)]
表示当前状态的价值等于一步奖励与下一状态价值之和的期望。这个递推关系称为Bellman 方程。
定义 3马尔可夫奖励过程
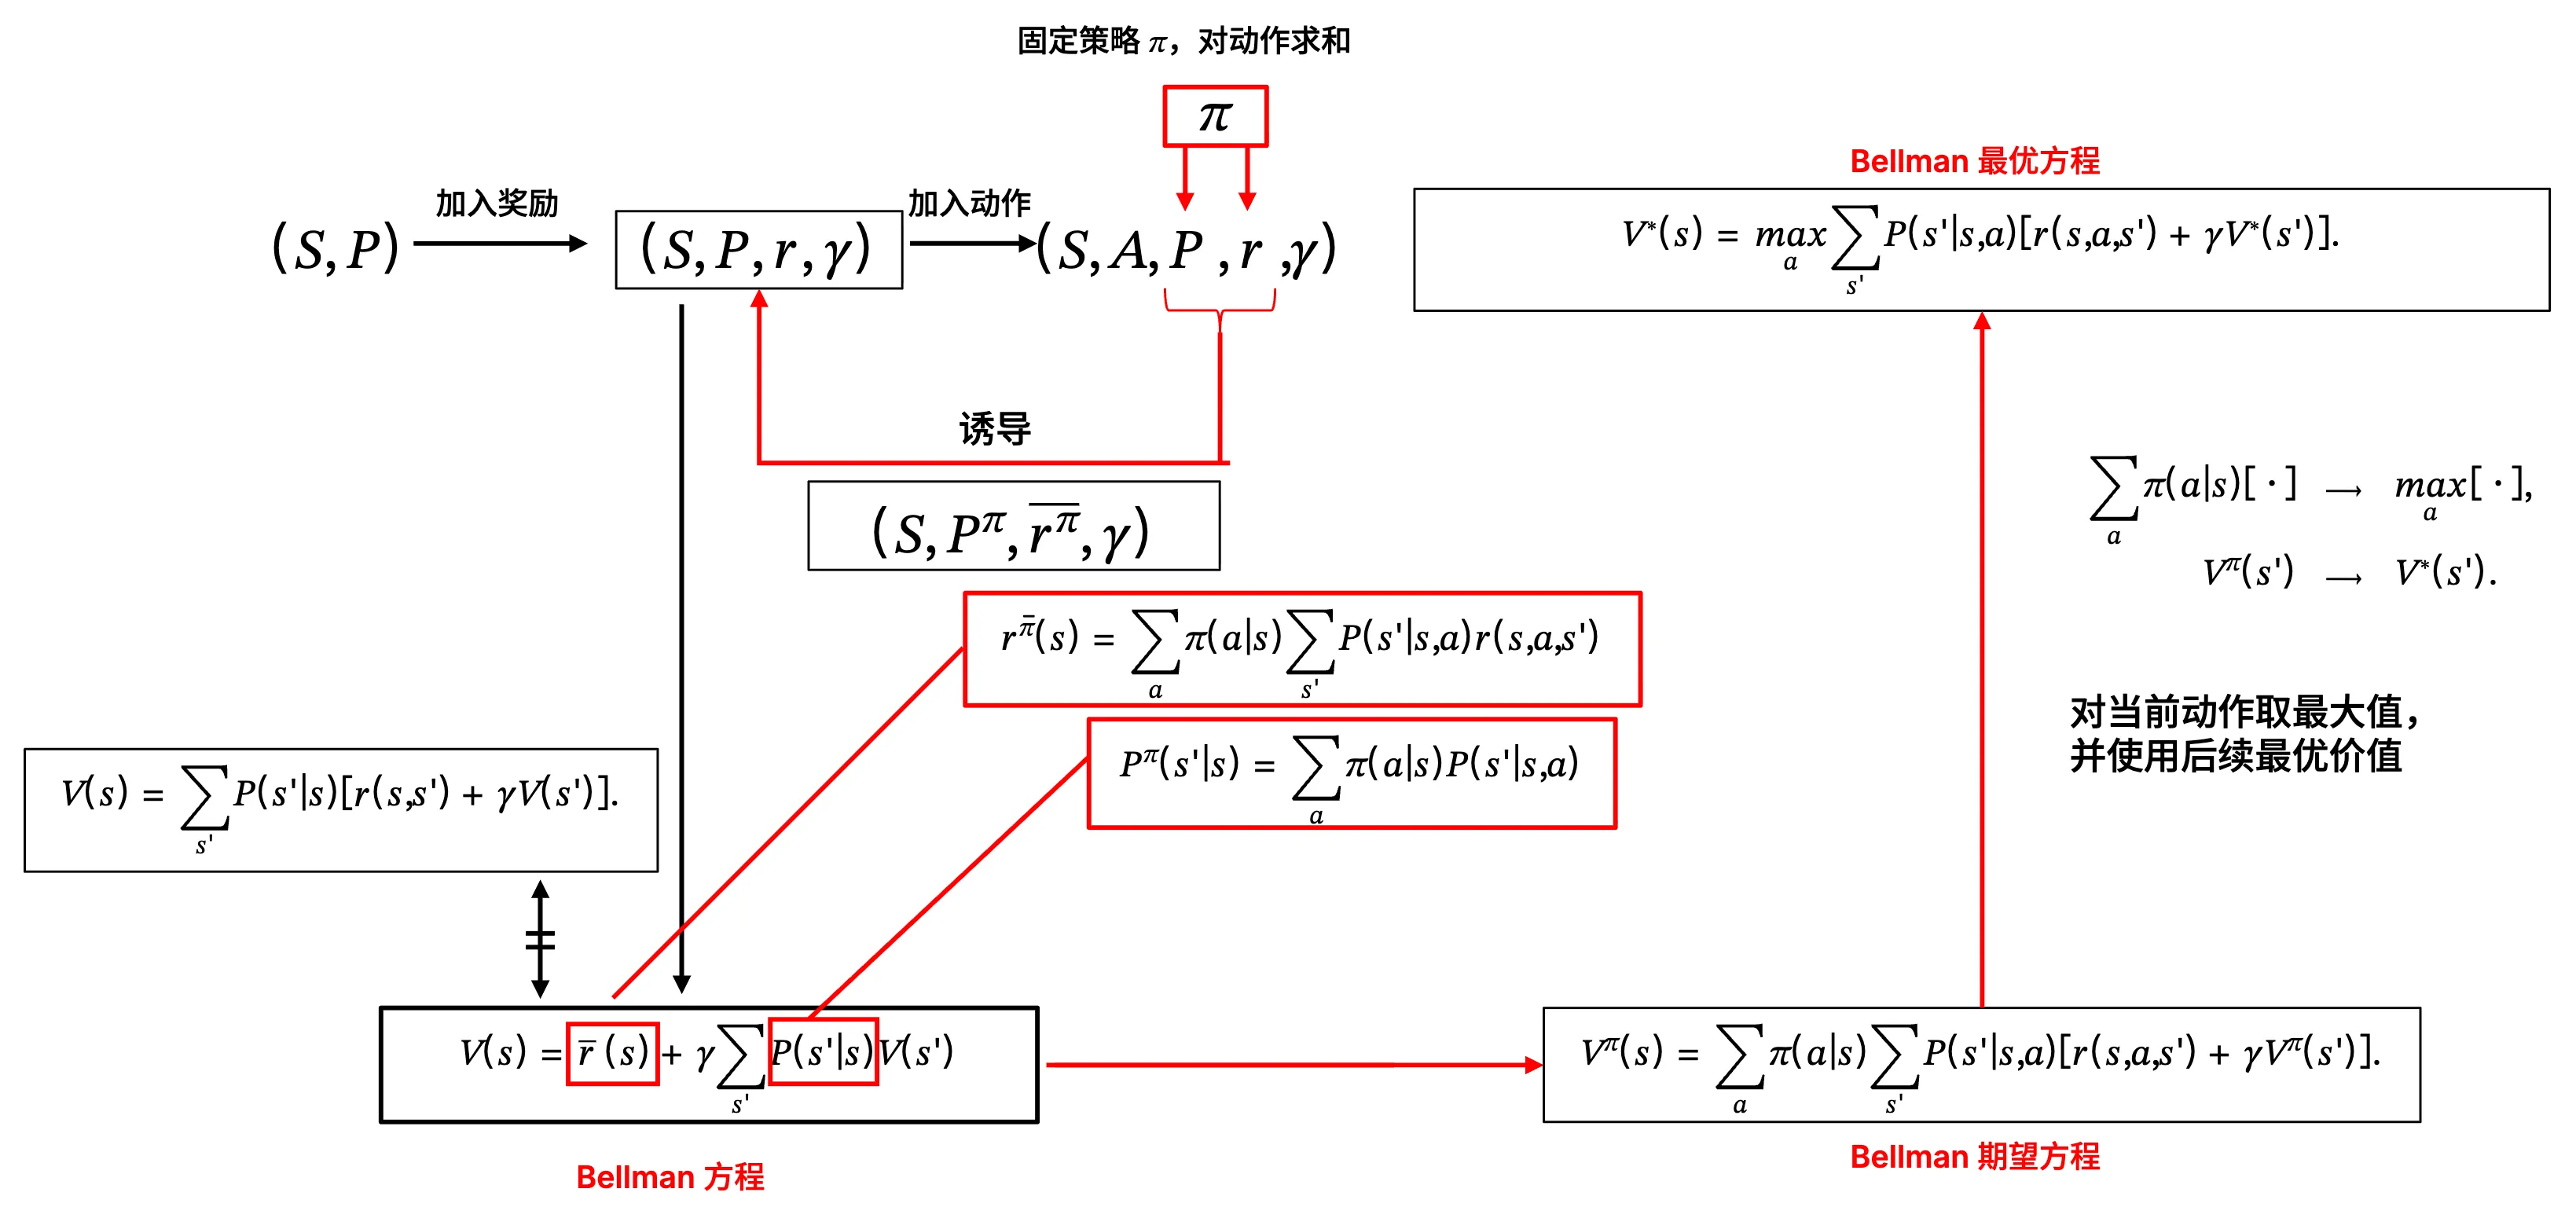
在马尔可夫过程的状态转移上定义奖励,并指定折扣因子 γ,就得到马尔可夫奖励过程,可以记为
(S,P,r,γ).
一般情况下,从第 t 步开始的折扣回报定义为
Gt=k=0∑∞γkRt+k+1.
将第一步奖励从回报中分离出来:
Gt=Rt+1+γGt+1.
定义 4价值函数
价值函数定义为
V(s)=E[Gt∣St=s].
在给定 St=s 的条件下,对回报递推式两边取期望:
V(s)=E[Rt+1+γGt+1∣St=s]=s′∑P(s′∣s)[r(s,s′)+γV(s′)].
这就是由 (S,P,r,γ) 定义的 MRP 的 Bellman 方程。
记状态 si 的单步期望奖励为
rˉ(si)=j∑P(sj∣si)r(si,sj).
对所有状态分别写出 Bellman 方程,并将结果排列成向量,可以得到
VV(s1)V(s2)⋮V(sn)=rˉrˉ(s1)rˉ(s2)⋮rˉ(sn)+γPP(s1∣s1)P(s1∣s2)⋮P(s1∣sn)P(s2∣s1)P(s2∣s2)⋮P(s2∣sn)⋯⋯⋱⋯P(sn∣s1)P(sn∣s2)⋮P(sn∣sn)VV(s1)V(s2)⋮V(sn).
即
V=rˉ+γPV.
当 0≤γ<1 时,I−γP 可逆,因此
V=(I−γP)−1rˉ.
2.3 前向占用与后向价值#
答案 1310 被我们使用两种方式得出,接下来我们尝试揭示其联系。
对于解法一,我们设的是状态 i 的单步期望奖励:
rˉ(i)=j∑Pijr(i,j).
在这里,rˉ(1)=32,rˉ(2)=rˉ(3)=0。
占用测度 μρ(i) 给出从初始分布 ρ 出发,状态 i 的期望访问次数。
用每个状态的期望访问次数乘以该状态的单步期望奖励,可以得到总期望回报:
Eρ[G]=i∑μρ(i)rˉ(i).
而对于解法二,价值函数 V(i) 给出从状态 i 出发的期望未来回报。用初始分布对各状态价值加权,也可以得到总期望回报:
Eρ[G]=i∑ρ(i)V(i).
即
按占用测度累计奖励1315⋅32+136⋅0+132⋅0=按初始分布计算价值1⋅V(1)+0⋅V(2)+0⋅V(3)=1310.
3 马尔可夫决策过程#
3.1 定义 MDP#
在前面的马尔可夫奖励过程中,粒子的转移规则已经由矩阵 P 确定。给定当前状态后,我们只能计算未来回报,无法选择接下来的转移方式。
定义 5马尔可夫决策过程
为此,我们在马尔可夫奖励过程中加入动作集合,并允许转移概率与奖励依赖动作,就得到马尔可夫决策过程(Markov Decision Process, MDP):
(S,A,P,r,γ).其中
SAP(s′∣s,a)r(s,a,s′)γ:状态空间,:动作空间,:状态转移概率,:执行动作并发生转移时的奖励,:折扣因子.
3.2 策略#
定义 6策略
在 MDP 中,策略是从状态到动作分布的映射:
π:S×A→[0,1],π(a∣s)=Pr(At=a∣St=s).满足对每个 s 有 ∑a∈Aπ(a∣s)=1。
3.3 策略诱导的 MRP#
策略 π 一旦固定,状态 s 下各个动作的选择概率也随之确定。将动作变量求和,可以得到策略 π 下的状态转移概率:
Pπ(s′∣s)=a∑π(a∣s)P(s′∣s,a).
相应的单步期望奖励为
rˉπ(s)=a∑π(a∣s)s′∑P(s′∣s,a)r(s,a,s′).
因此,每个策略都会在同一个 MDP 上诱导(induce)出一个 MRP。前面得到的 MRP Bellman 方程可以直接写成
Vπ=rˉπ+γPπVπ.
将矩阵方程按状态展开:
Vπ(s)=a∑π(a∣s)s′∑P(s′∣s,a)[r(s,a,s′)+γVπ(s′)].
这个方程在给定策略 π 后计算各个状态的价值,称为 Bellman 期望方程。
3.4 状态价值与动作价值#
定义 7状态价值与动作价值
给定策略 π,状态价值函数定义为
Vπ(s)=Eπ[Gt∣St=s].它表示当前位于状态 s,随后按照策略 π 选择动作时的期望回报。动作价值函数定义为
Qπ(s,a)=Eπ[Gt∣St=s,At=a].它表示当前位于状态 s,先执行动作 a,随后按照策略 π 行动时的期望回报。对于前面的容器问题,Vπ(s) 对应粒子位于仓 s、尚未选择动作时的价值,Qπ(s,a) 对应粒子已经决定选择动作 a 时的价值。
在状态 s 下,策略以概率 π(a∣s) 选择动作,因此
Vπ(s)=a∑π(a∣s)Qπ(s,a)(A)
当前动作 a 给定后,环境以概率 P(s′∣s,a) 转移到下一状态,因此
Qπ(s,a)=s′∑P(s′∣s,a)[r(s,a,s′)+γVπ(s′)](B)
式 (A) 对策略选择的动作求期望,式 (B) 对环境产生的下一状态求期望。将式 (A) 代入式 (B),还可以得到只包含动作价值的 Bellman 期望方程:
Qπ(s,a)=s′∑P(s′∣s,a)[r(s,a,s′)+γa′∑π(a′∣s′)Qπ(s′,a′)].
3.5 Bellman 最优方程#
定义 8最优价值函数
Bellman 期望方程用于计算给定策略的价值。为了比较所有策略,定义最优状态价值函数和最优动作价值函数:
V∗(s)=πmaxVπ(s),Q∗(s,a)=πmaxQπ(s,a).
在状态 s 下,选择使当前奖励与后续最优价值之和最大的动作,可以得到
V∗(s)=amaxs′∑P(s′∣s,a)[r(s,a,s′)+γV∗(s′)].
这就是状态价值函数的 Bellman 最优方程。对于动作价值函数,当前动作 a 已经给定,动作选择发生在到达下一状态以后:
Q∗(s,a)=s′∑P(s′∣s,a)[r(s,a,s′)+γa′maxQ∗(s′,a′)].
两种最优价值之间满足
V∗(s)=amaxQ∗(s,a).
得到 Q∗ 后,可以在每个状态选择动作价值最大的动作:
π∗(s)∈argamaxQ∗(s,a).
固定策略会诱导出一个 MRP,其价值满足 Bellman 期望方程;在可选动作中逐状态取最大值,则得到 Bellman 最优方程。