
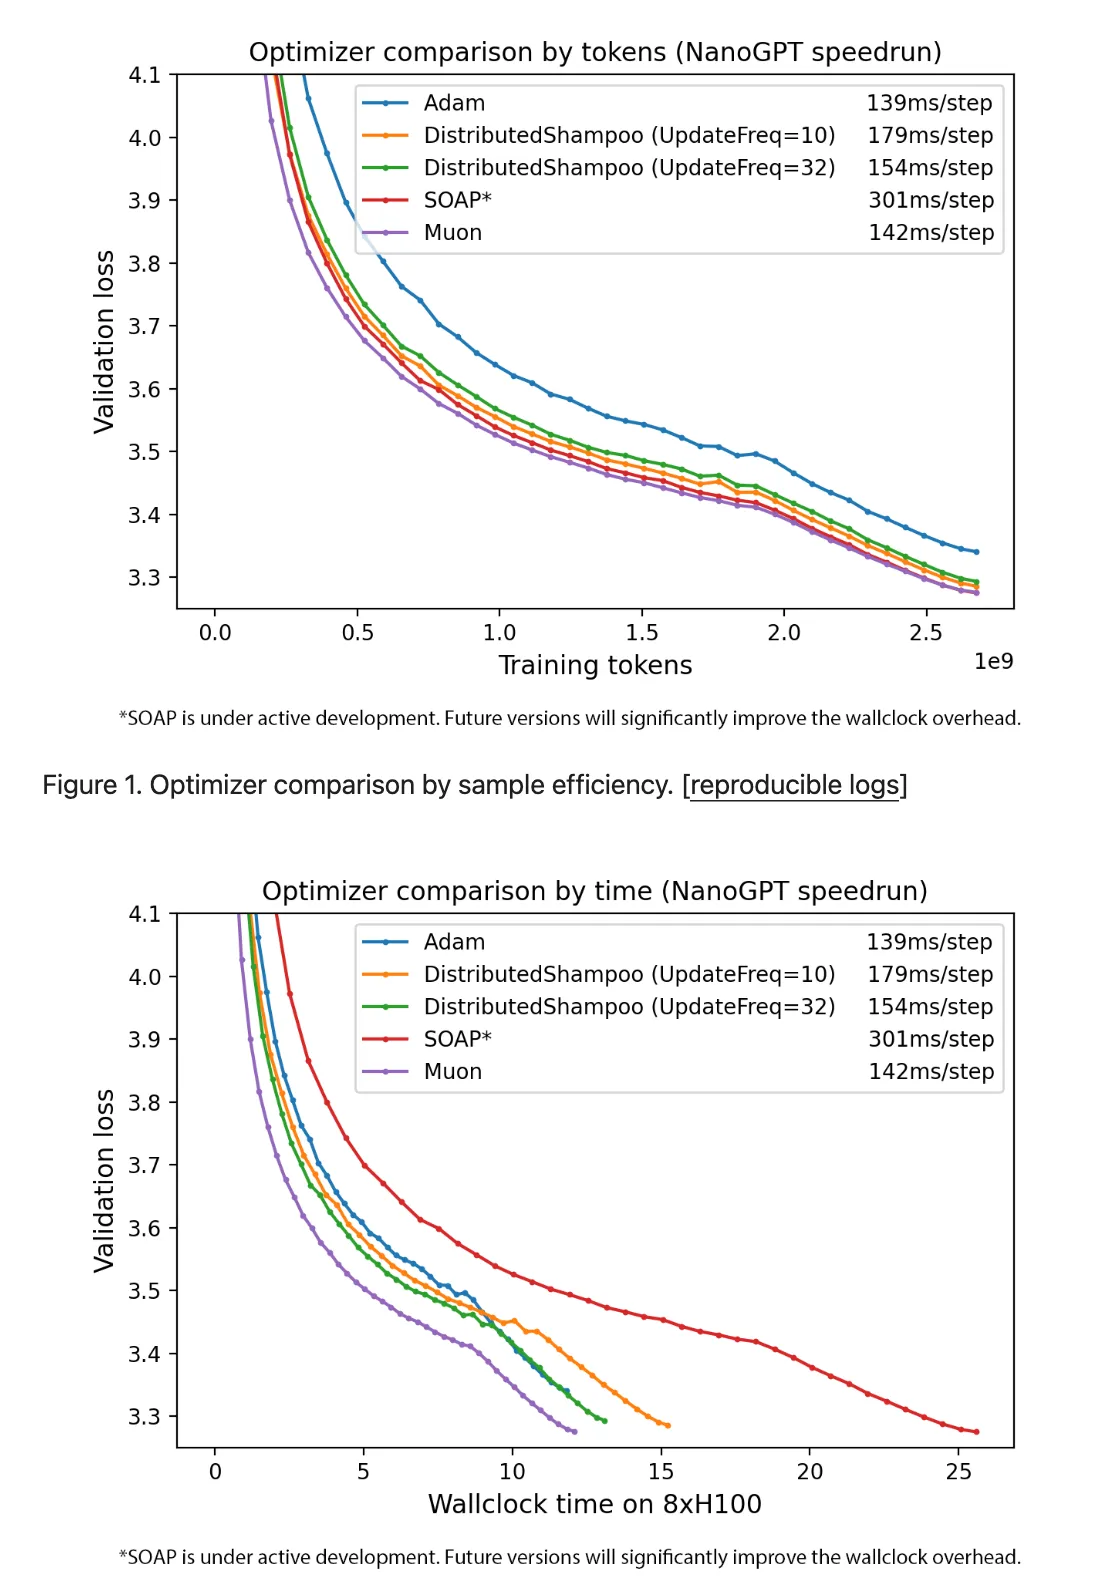
Muon 的效果:省显存且不影响收敛#
在训练模型时,对于一份参数,如果使用 AdamW,显存占用情况为:
- 2B,权重(bf16)
- 2B,梯度(bf16)
- 4B 一阶动量(fp32),4B,二阶动量(fp32)
则需要 12B 显存。
如果换用 Muon,显存占用情况为:
- 2B,权重(bf16)
- 2B,梯度(bf16)
- 4B Muon 动量(fp32)
则需要 8B 显存。
假设我们忽略一些 Muon 不利于非稠密矩阵优化的特性,同样的显存条件下,按上面的统计,使用 Muon 替代 AdamW 进行训练可以多放下一半的参数( 倍)!
Kimi 使用 Muon 训练 Moonlight 模型1证明了 Muon 的实用性,接下来我们浅析 Muon 优化器相对于已有的、广泛流行的优化器的区别与适用范围。
传统的优化器:把一切当做向量优化#
优化器:在数亿参数的空间 里,对非凸函数 ,求解 。
下面我们从最原始的 SGD 开始构建出 AdamW,这一十余年被广泛使用的优化器之形态。
随机梯度下降(Stochastic Gradient Descent, SGD)#
用 minibatch 估计:
记号约定: 为第 步的参数, 为梯度, 为学习率。
引入 Momentum#
优化器保存动量 ,累积历史梯度。
衰减系数 决定“过去的信息保留多久、当前值更新时新旧数据各占多少权重”。指数滑动平均(EMA)一般能记住 步的信息。
RMSProp#
在平坦的地方加速,在陡峭的地方减速。
为梯度平方的 EMA,运算按元素进行。 是防止除零的数值稳定性技巧。
这个自适应学习率是工程直觉 + 启发式设计(归一化)。
Adam#
Who is Adam ?
缝合怪:Momentum 的一阶矩加 RMSProp 的二阶矩2。
AdamW3:把权重衰减从梯度计算里移动到最后更新参数那一步,权重衰减不会被 Adam 的自适应缩放机制干扰。 为权重衰减系数:
Muon:尝试利用矩阵的信息#
记号: 为 的权重矩阵,, 为动量。与 Momentum 相比,只在更新参数前多了一步 4:
msign#
是 的矩阵版本:只保留矩阵的“方向”,把大小全部抹平。
对矩阵 做奇异值分解(SVD):
是正交矩阵, 是对角矩阵,对角线上是奇异值 。则
即把 换成单位矩阵,所有奇异值都变成 1。
例:,奇异值是 和 ,,所以 。原来 与 相差 6 倍,处理后两个方向的更新幅度相同。
Newton–Schulz 迭代#
训练中直接做 SVD 太慢,在 Moonlight 的论文中,实际的优化器使用(沿用论文记号: 为动量系数, 为学习率):
Newton–Schulz 步骤如下:
设 ,则一步迭代的结果为
即对每个奇异值独立套用同一个标量多项式 ,奇异向量保持不变,迭代多次后奇异值接近 1。 除以 是为了让所有奇异值落在 内。
这里有三个 magic number:,苏神在博客5还原了 modded-nanogpt 制造他们的方式:在迭代 5 步的限制下,求使奇异值最接近 1 的系数。
Muon 为什么有效:众说纷纭#
此前的优化器逐元素处理参数,Muon 把一层权重当作整个矩阵处理。当 为对角矩阵时,,Muon 退化为 signSGD6(只取梯度符号的优化器)。
Muon 为什么有效,目前没有定论,下面是文献中提出的几种可能因素:
-
补足被压制的方向:梯度矩阵常由少数大奇异值主导,msign 把其余方向的步长拉到相同水平。
-
免累积的 Shampoo:Muon 等价于没有累积统计量的 Google Shampoo7,保留了二阶预条件的结构,只需要一份动量。
-
大 batch 下保持数据效率:Essential AI 的实验显示,batch 变大时 Muon 比 AdamW 更能保持数据效率8。
这些因素哪一个起主要作用,不知道。
经验与工程中的适用范围#
对我们来说,Muon 该被如何使用也许才是更重要的事情。经验性的结论是,把稠密的矩阵交给 Muon。
embedding、输出层、bias 和 norm 的缩放参数还是应该用 AdamW——这些应该被视作向量。
同时,非常遗憾的是,Muon 和 AdamW 训出来的模型可能收敛到的不是同一类解9。如果预训练用的是 AdamW,而后训练使用 Muon 在一些情况下无显著收益10。
即便如此,节约显存已经是一件很伟大的事情了。
Footnotes#
-
Jingyuan Liu 等. Muon is Scalable for LLM Training. 2025. arXiv:2502.16982 ↩
-
Diederik P. Kingma, Jimmy Ba. Adam: A Method for Stochastic Optimization. 2014. arXiv:1412.6980 ↩
-
Ilya Loshchilov, Frank Hutter. Decoupled Weight Decay Regularization. 2017. arXiv:1711.05101 ↩
-
Keller Jordan 等. Muon: An optimizer for hidden layers in neural networks. 2024. ↩
-
苏剑林. Muon优化器赏析:从向量到矩阵的本质跨越. 科学空间, 2024. ↩
-
Jeremy Bernstein 等. signSGD: Compressed Optimisation for Non-Convex Problems. 2018. arXiv:1802.04434 ↩
-
Vineet Gupta, Tomer Koren, Yoram Singer. Shampoo: Preconditioned Stochastic Tensor Optimization. 2018. arXiv:1802.09568 ↩
-
Essential AI. Practical Efficiency of Muon for Pretraining. 2025. arXiv:2505.02222 ↩
-
Chen Fan, Mark Schmidt, Christos Thrampoulidis. Implicit Bias of Spectral Descent and Muon on Multiclass Separable Data. NeurIPS 2025. 该工作研究多类线性可分数据上的隐式偏置。 ↩
-
Jingyuan Liu 等. Muon is Scalable for LLM Training. 2025. 第 3.5、4 节。 ↩